JVM原理解析与实战
一、JVM介绍
1.JVM是什么
Java Virtual Machine(Java虚拟机)是java程序实现跨平台的一个重要的工具(部件)。
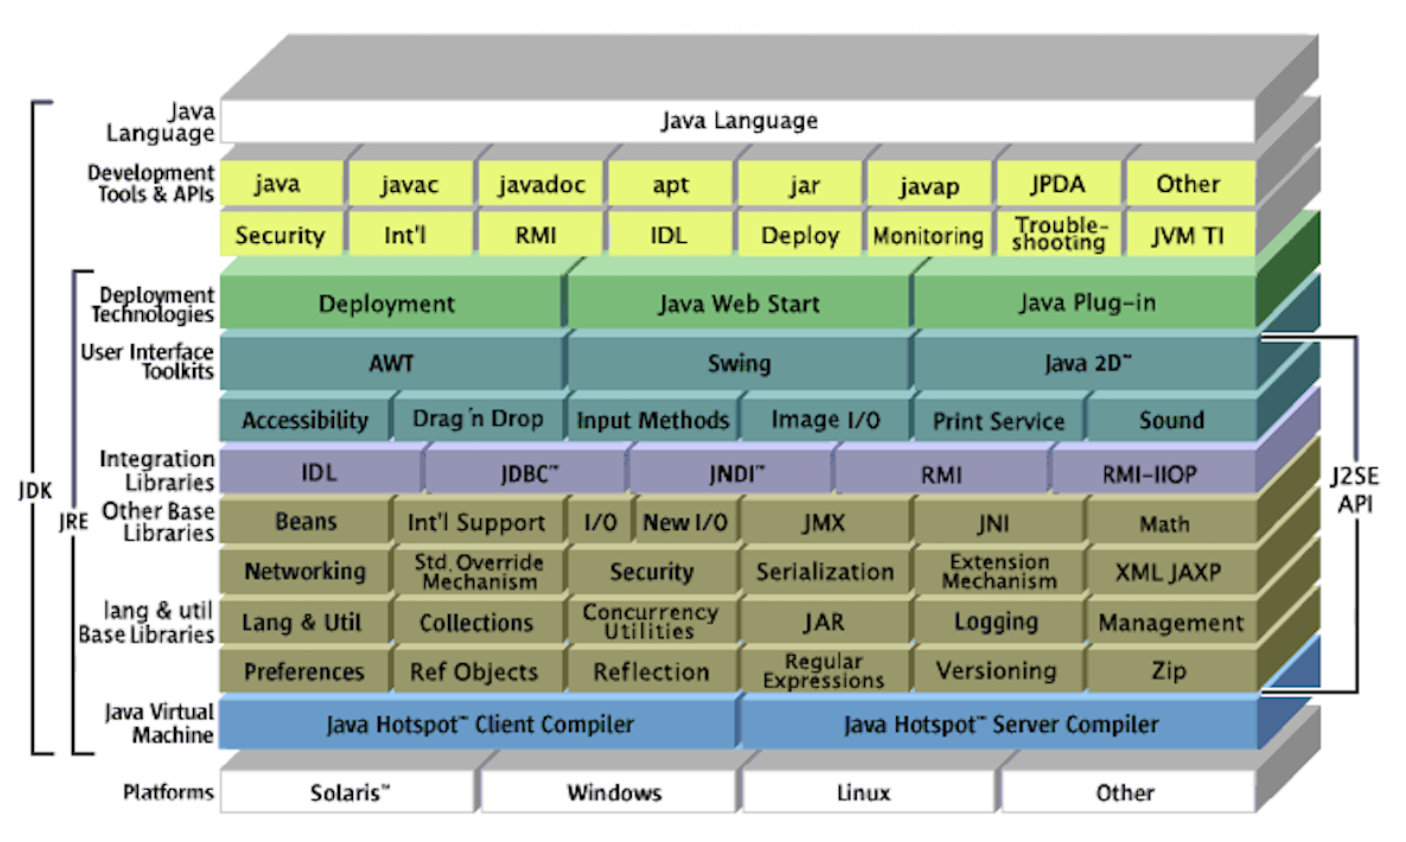 JVM全貌
HotSpot VM,相信所有Java程序员都知道,它是Sun JDK和OpenJDK中所带的虚拟机,也是 目前使用范围最广的Java虚拟机。
只要装有JVM的平台,都可以运行java程序。那么Java程序在JVM上是怎么被运行的?
通过介绍以下JVM的三个组成部分,就可以了解到JVM内部的工作机制
- 类加载系统:负责完成类的加载
- 运行时数据区:在运行Java程序的时候会产生的各种数据会保存在运行时数据区
- 执行引擎:执行具体的指令(代码)
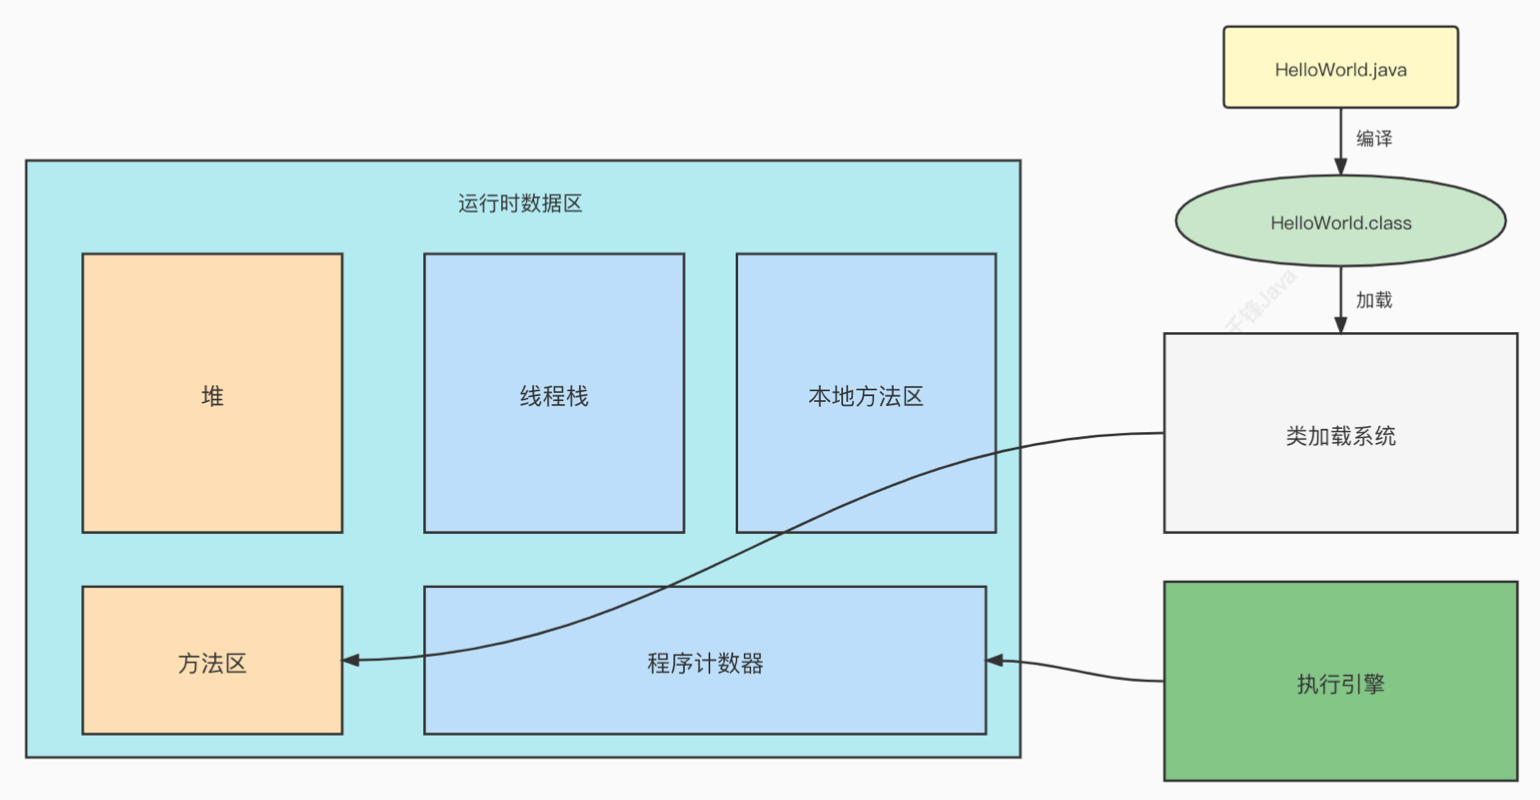 JVM组件
2.学习目标
我们学JVM相关知识的目的是为了充分理解jvm内部的工作流程,来掌握如何通过相应的参数配置,实现JVM的调优。
二、类加载系统
1.类的加载过程
一个类被加载进JVM中要经历哪几个过程
- 加载: 通过io流的方式把字节码文件读入到jvm中(方法区==jdk8以后叫元空间)
- 校验: 通过校验字节码文件的头4位的16进制是否是java魔数cafebabe
- 准备: 为类中的静态部分开辟空间并赋初始化值,例如public static int count = 10;
- 解析: 将符号引用转换成直接引用。——静态链接,例如 jvmAnalyze.add()的.add()相当于一次引用。动态连接表示代码执行到该位置才会去寻找对应指令。
- 初始化: 为类中的静态部分赋指定值并执行静态代码块。
类被加载后,类中的类型信息、方法信息、属性信息、运行时常量池、类加载器的引用等信 息会被加载到元空间中。
常量值属于不会被回收的空间。jdk8以后把常量值移到了堆内。
1
2
3
4
5
# -v 输出附加信息verbose
javap -v xxx.class

# -c 对代码进行反汇编
javap -c xxx.class
constant pool 常量值
2.类加载器
类是谁来负载加载的?——类加载器
- Bootstrap ClassLoader 启动类加载器:负载加载jre/lib下的核心类库中的类,比如 rt.jar、charsets.jar
- ExtClassLoader 扩展类加载器:负载加载jre/lib下的ext目录内的类
1
ext 加载路径:System.getProperty("java.ext.dirs");
- AppClassLoader 应用类加载器:负载加载用户自己写的类
1
app 加载路径:System.getProperty("java.class.path");
- 自定义类加载器: 自己定义的类加载器,可以打破双亲委派机制。
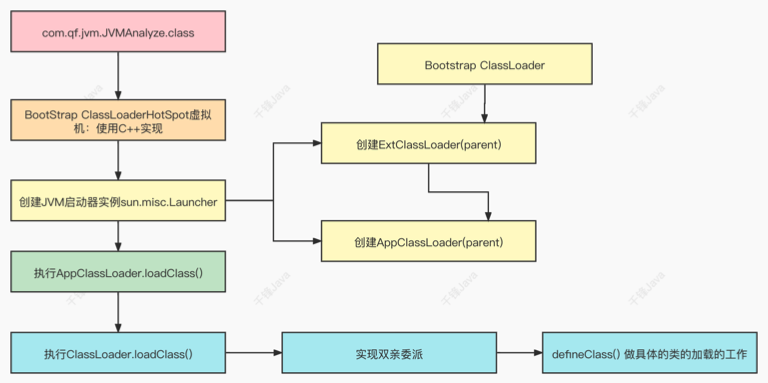 自定义类加载过程,com.qf.JVMAnalyze.class是用户写的类
1
2
3
4
5
6
7
ClassLoader classLoader1 = Object.class.getClassLoader(); // java自身类的类加载器
ClassLoader classLoader2 = EyentID.class.getClassLoader(); // java扩展类的类加载器
ClassLoader classLoader3 = LoadClassAnalyze1.class.getClassLoader(); // 用户自己写的类加载器

System.out.println("classLoader1:" + classLoader1);
System.out.println("classLoader2:" + classLoader2);
System.out.println("classLoader3:" + classLoader3);
1
2
3
classLoader1:null
classLoader2:sun.misc.Launcher$ExtClassLoader@5e2de80c
classLoader3:sun.misc.Launcher$AppClassLoader@18b4aac2
可以看到java自身类的类加载器是看不到的,因为用c++编写的,扩展类的类加载器可以看到是ExtClassLoader进行加载的,用户自身的类加载器是AppClassLoader进行加载的。
三、双亲委派机制
1.双亲委派机制介绍
当类加载进行加载类的时候,类的加载需要向上委托给上一级的类加载器,上一级继续向上委托,直到启动类加载器。启动类加载器去核心类库中找,如果没有该类则向下委派,由下一级扩展类加载器去扩展类库中,如果也没有继续向下委派,直到找不到为止,则报类找不到的异常。
1
2
3
4
5
6
7
public class TestJMM {
  //静态属性
  public static int baseData = 10;
  //静态属性
  public static Student student = new Student();
  public static String hello = "hello";
}
应用类加载器怎么加载Student和String呢? 需要通过双亲委派机制
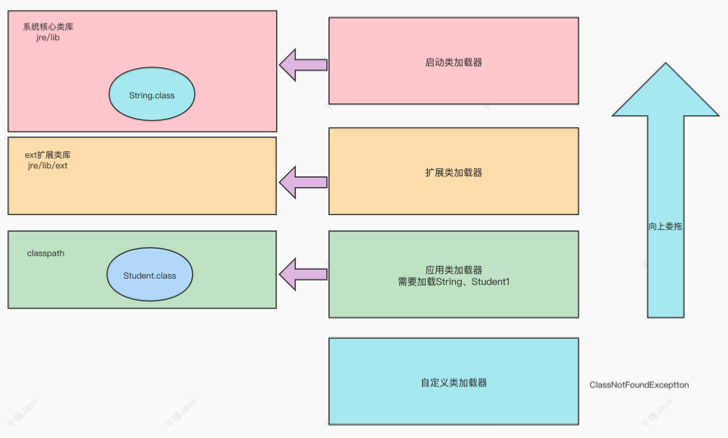 双亲委派机制
因为如果不使用双亲委派机制,那么用户自定义了一个例如java.lang.String,则会替代掉java核心库的String类。导致原有的核心类被覆盖。
2.为什么要有双亲委派机制
- 防止核心类库中的类被随意篡改
- 防止类的重复加载
3.双亲委派机制核心源码
ClassLoader.class
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
protected Class<?> loadClass(String name, boolean resolve)throws ClassNotFoundException{

    synchronized (getClassLoadingLock(name)) {
        // First, check if the class has already been loaded
        Class<?> c = findLoadedClass(name); if(c==null){
            long t0 = System.nanoTime();

            try {
                if (parent != null) {
                    c = parent.loadClass(name, false); // 这句是核心
                } else {
                    c = findBootstrapClassOrNull(name);
                }
            } catch (ClassNotFoundException e) {
                // ClassNotFoundException thrown if class not found
                // from the non-null parent class loader
            }

            if (c == null) {
                // If still not found, then invoke findClass in order
                // to find the class.
                long t1 = System.nanoTime();
                c = findClass(name);

                // this is the defining class loader; record the stats
                sun.misc.PerfCounter.getParentDelegationTime().addTime(t1 - t0);
                sun.misc.PerfCounter.getFindClassTime().addElapsedTimeFrom(t1);
                sun.misc.PerfCounter.getFindClasses().increment();
            }
        }

        if (resolve) {
            resolveClass(c);
        }

        return c;
    }
}
4.全盘委托机制
当一个类被当前的ClassLoader加载时,该类中的其他类也会被当前该ClassLoader加载。除非指明其他由其他类加载器加载。
避免频繁切换类加载器造成系统开销。
5.自定义类加载器实现双亲委派机制
- 自定义类加载机制
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
public class MyClassLoader extends ClassLoader{

        private String classPath;

        public MyClassLoader(String classPath){
                this.classPath = classPath;
        }

        @Override
        protected Class<?> findClass(final String name)throws ClassNotFoundException{
                try {
                        //1.读入指定路径的classPath下的类
                        String path = name.replace('.', '/').concat(".class");
                        FileInputStream fileInputStream = new FileInputStream(classPath+"/"+path);
                        byte[] data = new byte[fileInputStream.available()];
                        fileInputStream.read(data); fileInputStream.close();
                        //2.加载该类
                        return defineClass(name, data,0,data.length);
                } catch (Exception e) {
                        e.printStackTrace();
                        throw new ClassNotFoundException();
                }
        }
}
- 启动自定义类加载器
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
public class TestMyClassLoader {

        public static void main(String[] args) throws Exception {
                //1.创建自定义类加载器,指定加载路径
                MyClassLoader myClassLoader = new
                MyClassLoader("/Users/zeleishi/Documents/工作/授课/2104/第四阶 段/myclass");
                //2.指定要加载的类名
                Class<?> clazz = myClassLoader.loadClass("com.qf.jvm.JVMAnalyze");
                //3.反射创建对象
                Object obj = clazz.newInstance();
                //4.创建add方法对象
                Method add = clazz.getDeclaredMethod("add", null);
                //5.调用对象的add方法
                Object result = add.invoke(obj);
                //6.打印结果
                System.out.println(result);
        }
}
6.自定义类加载器打破双亲委派机制
实现自定义类加载器打破双亲委派机制,其实就是加载ClassLoader之后重写findClass方法。
类加载过程
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
/**
重写loadClass方法
*/
protected Class<?> loadClass(String name, boolean resolve)throws ClassNotFoundException {

        synchronized (getClassLoadingLock(name)) {

                // First, check if the class has already been loaded
                Class<?> c = findLoadedClass(name); if (c == null) {
                        // If still not found, then invoke findClass in order
                        // to find the class.
                        long t1 = System.nanoTime();
                        //对于Object类,使用父加载器
                        if(!name.startsWith("com.qf.jvm")){
                                c = this.getParent().loadClass(name);
                        }else{
                                c = findClass(name);
                        }

                        // this is the defining class loader; record the stats
                        sun.misc.PerfCounter.getFindClassTime().addElapsedTimeFrom(t1);
                        sun.misc.PerfCounter.getFindClasses().increment();
                }

                if (resolve) {
                        resolveClass(c);
                }

                return c;
        }
}
四、运行时数据区
1.运行时数据区介绍
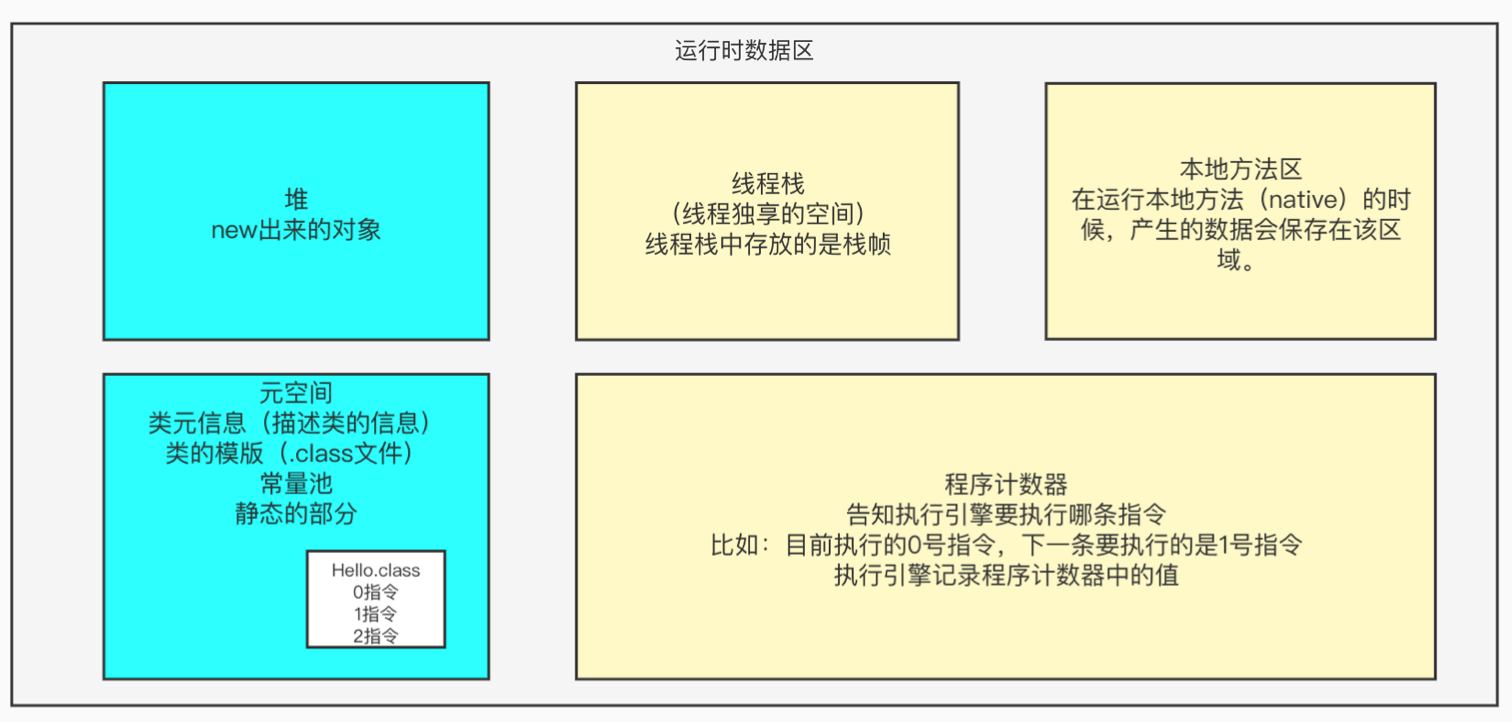 运行时数据区,蓝色是线程共享区域,黄色是线程独享区域
运行时数据区也就是JVM在运行时产生的数据存放的区域,这块区域就是JVM的内存区域,也称为JVM的内存模型——JMM
JMM分成了这么几个部分
- 堆空间(线程共享): 存放new出来的对象
- 元空间(线程共享): 存放类元信息、类的模版、常量池、静态部分、指令和代码。内容都是0和1
- 线程栈(线程独享): 方法的栈帧
- 本地方法栈(线程独享): 本地方法产生的数据
- 程序计数器(线程独享): 配合执行引擎来执行指令。
程序计数器告知执行引擎要执行哪命令,执行引擎去元空间执行指令的过程当中,产生的数据,如果是new出来的对象,则放到堆空间,如果是局部变量或操作动作就放到线程栈内,如果是本地方法产生的数据就放到本地方法栈。
我们可以通过反汇编javap -c xxx.class查看具体的指令集,并通过指令集了解运行时数据区内部具体是如何运行的,指令集可在Java指令集内查找
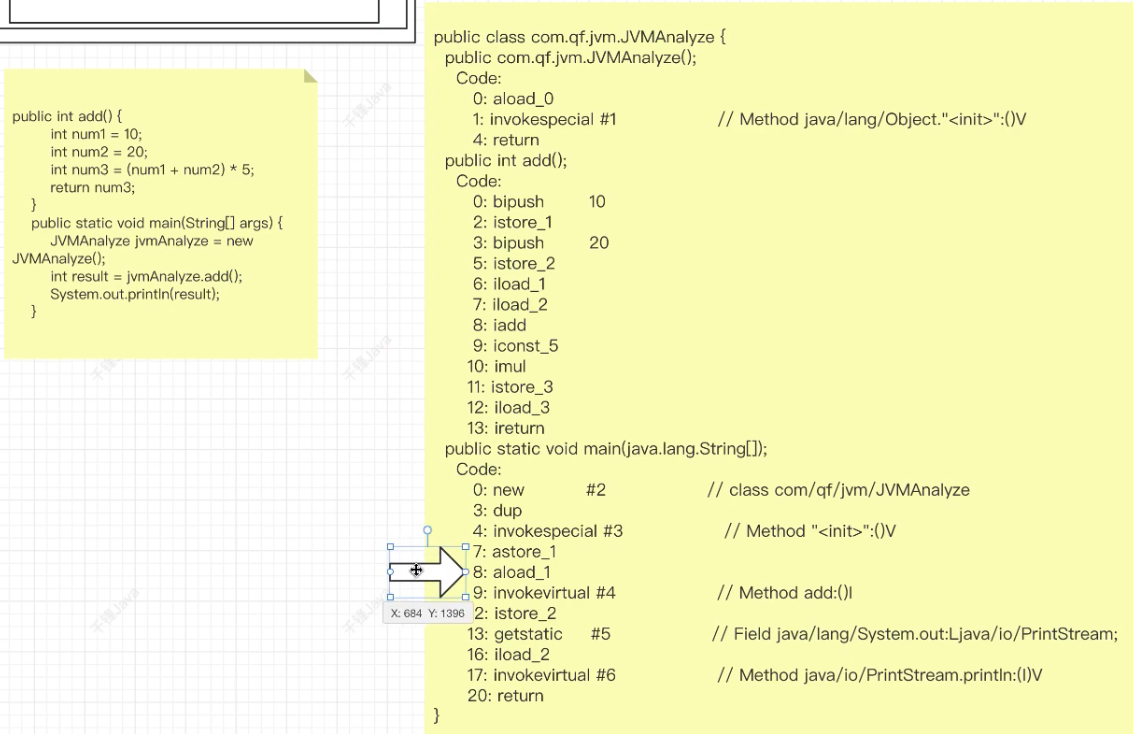 代码与指令集
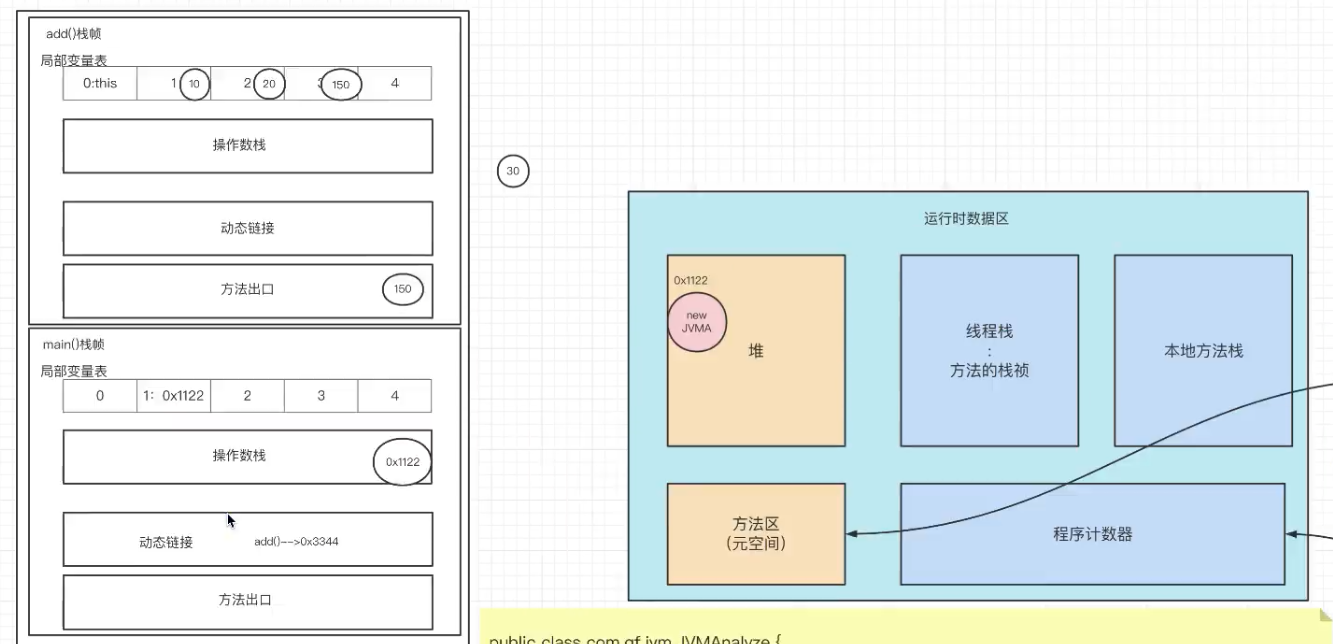 堆内栈帧与运行时数据区,add()方法执行完就出栈,main()方法同理
通过指令,我们了解到JMM内存发生了如下变化:
- 线程栈: 执行一个方法就会在线程栈中创建一个栈帧。
栈帧包含如下四个内容:
- 局部变量表: 存放方法中的局部变量
- 操作数栈: 用来存放方法中要操作的数据
- 动态链接: 存放方法名和方法内容的映射关系,通过方法名找到方法内容(符号引用转换成直接引用,例如: add() –> 0x3344(内存地址))
- 方法出口: 记录方法执行完后调用次方法的位置。
2.程序在执行时运行时数据区中的内存变化
五、对象的创建流程
1.对象创建流程
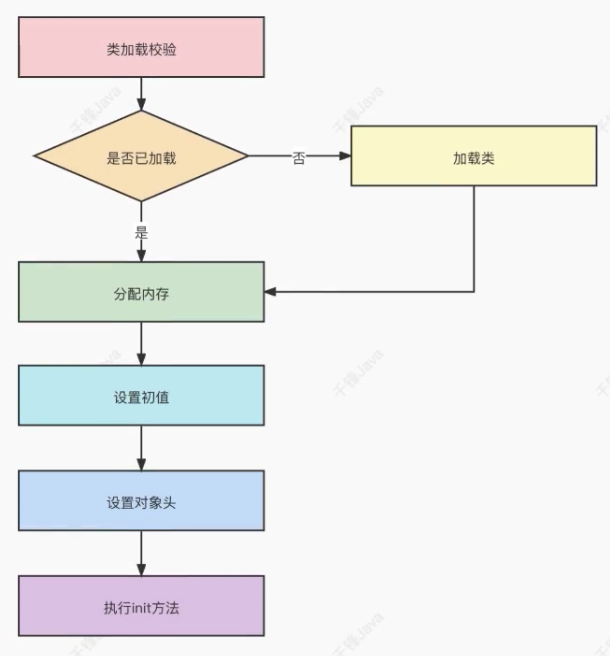 对象创建流程
2.类加载校验
校验该类是否已被加载。主要是检查常量池中是否存在该类的类元信息。如果没有,则需要进行加载。
3.分配内存
为对象分配内存。具体的分配策略如下:
- Bump the Pointer(指针碰撞): 如果内存空间的分配是绝对规整的,则JVM记录当前剩 余内存的指针,在已用内存分配。例如0-4字节被使用,4-9字节是空闲的,10-14又是被使用的则无法使用指针碰撞策略。
- Free List(空闲列表): 如果内存空间的分配不规整,那么JVM会维护一个可用内存空间的列表用于分配。例如我有一张空闲列表记录了内存内有4个字节的空闲位置,那么会告知哪个位置可以使用。
对象并发分配存在的问题:
- Compare And Swap: 自旋分配,如果并发分配失败则重试分配之后的地址。例如两个线程要同时创建空间,系统告知指针0x5566这个位置开始是空闲位置,线程1在空闲位置创建成功,但是线程2就会没法创建了,这时候需要使用自旋获取下一片空闲空间。
- Thread Local Allocation Buffer(TLAB): 本地线程分配缓冲,JVM被每个线程分配一块空间,每个线程在自己的空间中创建对象(jdk8默认使用,之前版本需要通过- XX:+UseTLAB开启)。也就是说每一条线程会独立分配空间,让你去创建对象。
4.设置初值
根据数据类型,为对象空间赋初始化值。
5.设置对象头及指针压缩
为对象设置对象头信息,对象头信息包含以下内容:类元信息、对象哈希码、对象年龄、锁状态标志等。
- 对象头中的Mark Work字段(32位)
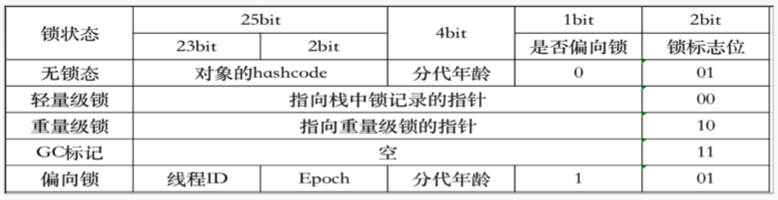 Mark Work字段
通过对象头的Mark Work字段的锁状态来得知当前的并发情况,如果锁情况很严重的情况,也就是重量级锁,那么锁标志位会是10。
- 对象头中的类型指针(Klass Pointer)
类型指针用于指向元空间当前类的类元信息。比如调用类中的方法,通过类型指针找到元空间中的该类,再找到相应的方法。 开启指针压缩后,类型指针只用4个字节存储,否则需要8个字节存储
- 指针压缩(减少占用空间)
过大的对象地址,会占用更大的带宽和增加GC的压力。
对象中指向其他对象所使用的指针: 8字节被压缩成4字节。最早的机器是32位,最大支持内存2的32次方=4G。现在是64位,2的64次方可以表示N个T的内存。内存32G即等于2的35次 方。如果内存是32G的话,用35位表示内存地址,这样过于浪费。如果把35位的数据,根据 算法,压缩成32位的数据(也就是4个字节)。在保存时用4个字节,再使用时使用8个字节。 之前用35位保存内存地址,就可以用32位保存。这样8个字节的对象,实际上使用32位来保存,这样64位就能表示2个对象。
如果内存大于32G,指针压缩会失效,会强制使用64位来表示对象地址。因此jvm堆内存最好 不要大于32G。
Jdk1.6之后默认开启指针压缩,可通过配置jvm参数关闭指针要锁 -XX:-UseCompressedOops。
例如不开启,则存储String占8字节,开启后存储占4字节。使用时再回到8字节。
示例代码
1
2
3
4
5
6
7
8
9
10
11
12
/**
* 对象指针压缩
*/
public class ObjectLengthAnalyze {
public static void main(String[] args) {
ClassLayout classLayout = ClassLayout.parseInstance(new A()); System.out.println(classLayout.toPrintable());
}
    static class A{
        int num;
        String name;
    }
}
关闭指针压缩:
6.执行init方法
为对象中的属性赋值和执行构造方法。
六、垃圾回收机制
1.对象成为垃圾的判断依据(引用或根节点可达性)
在堆空间和元空间中,GC这条守护线程会对这些空间开展垃圾回收工作,那么GC如何判断这 些空间的对象是否是垃圾,有两种算法:
- 引用计数法:
对象被引用,则计数器+1,如果计数器是0,那么对象将被判定为是垃圾,于是被回收。但是这种算法没有办法解决循环依赖的对象。因此JVM目前的主流厂商Hotspot没有使用这种算法。
- 可达性分析算法: GC Roots根
- gc roots根节点: 在对象的引用中,会有这么几种对象的变量: 来自于线程栈中的局部变量表中的变量、静态变量、本地方法栈中的变量,这些变量都被称为gc roots根节点
- 判断依据: gc在扫描堆空间中的某个节点时,向上遍历,看看能不能遍历到gc roots根节点,如果不能,那么意味着这个对象是垃圾。
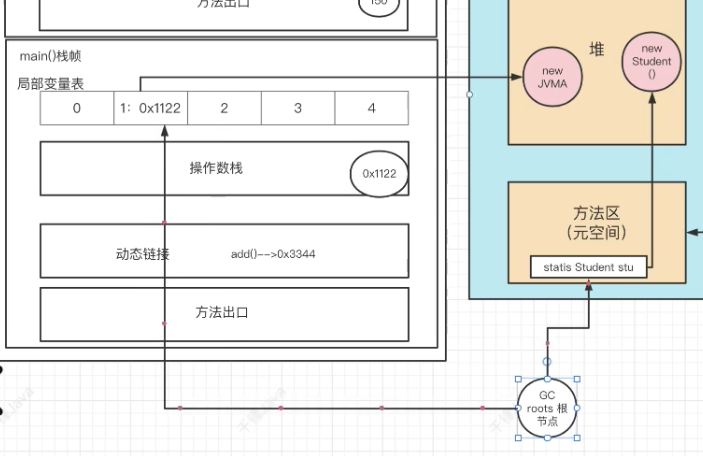 gcRoots根节点样例
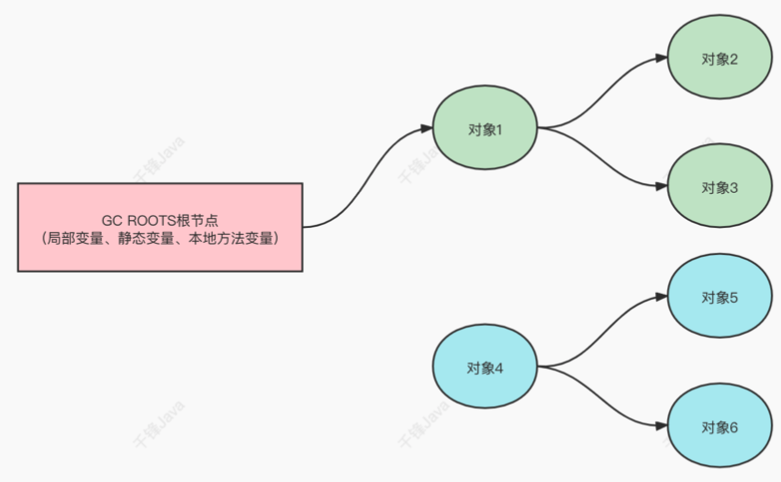 对象成为垃圾的判断依据
2.对象中的finalize方法
Object类中有一个finalize方法,也就是说任何一个对象都有finalize方法。这个方法是对象被回收之前的最后一根救命稻草。
- GC在垃圾对象回收之前,先标记垃圾对象,被标记的对象的finalize方法将被调用
- 调用finalize方法如果对象被引用,那么第二次标记该对象,被标记第二次的对象将移除出即将被回收的集合,继续存活
- 调用finalize方法如果对象没有被引用,那么将会被回收
- 注意,finalize方法只会被调用一次。
过程:GC检查到A对象没有gcRoot -> 标记为垃圾 -> 执行A对象内部的finalize方法 -> 且第二次添加标记 -> 移除被回收集合 -> 第二次GC检查A对象没有gcRoot -> 标记为垃圾 -> 因为上一次已经执行过finalize方法了 -> 所以等回收来了就会被回收掉
3.对象的逃逸分析(方法有返回且无引用,直接在栈空间创建,无需gc)
在jdk1.7之前,对象的创建都是在堆空间中创建,但是会有个问题,方法中的未被外部访问的对象
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
// 在jdk1.7之前,下面两个方法为示例。
// 未逃逸,也就是该方法test1无返回,里面的User会随着test1()方法的销毁而销毁,这种对象会在栈空间创建。
public void test1() {
    User user = new User();
    user.setId(1);
    user.setName("xiaoming");
}

// 逃逸,该方法test2()返回了User,这个返回的User可能会被调用,就不会在栈空间进行分配。
public User test2() {
    User user = new User();
    user.setId(1);
    user.setName("xiaoming");
    return user;
}
这种对象没有被外部访问,且在堆空间上频繁创建,当方法结束,需要被gc,浪费了性能。
所以在1.7之后,就会进行一次逃逸分析(默认开启),于是这样的对象就直接在栈上创建,随着方法的出栈而被销毁,不需要进行gc。
在栈上分配内存的时候: 会把聚合量替换成标量,来减少栈空间的开销,也为了防止栈上没有足够连续的空间直接存放对象。
- 标量: java中的基本数据类型(不可再分)。
- 标量替换: 会将User拆分成id和name放在栈上,由id和name组成的空间内容就是一个User对象。有了这个动作就可以节约User对象在栈上分配所占用的空间。
- 聚合量: 引用数据类型。
七、垃圾回收算法
1、标记清除算法、复制算法、标记整理算法
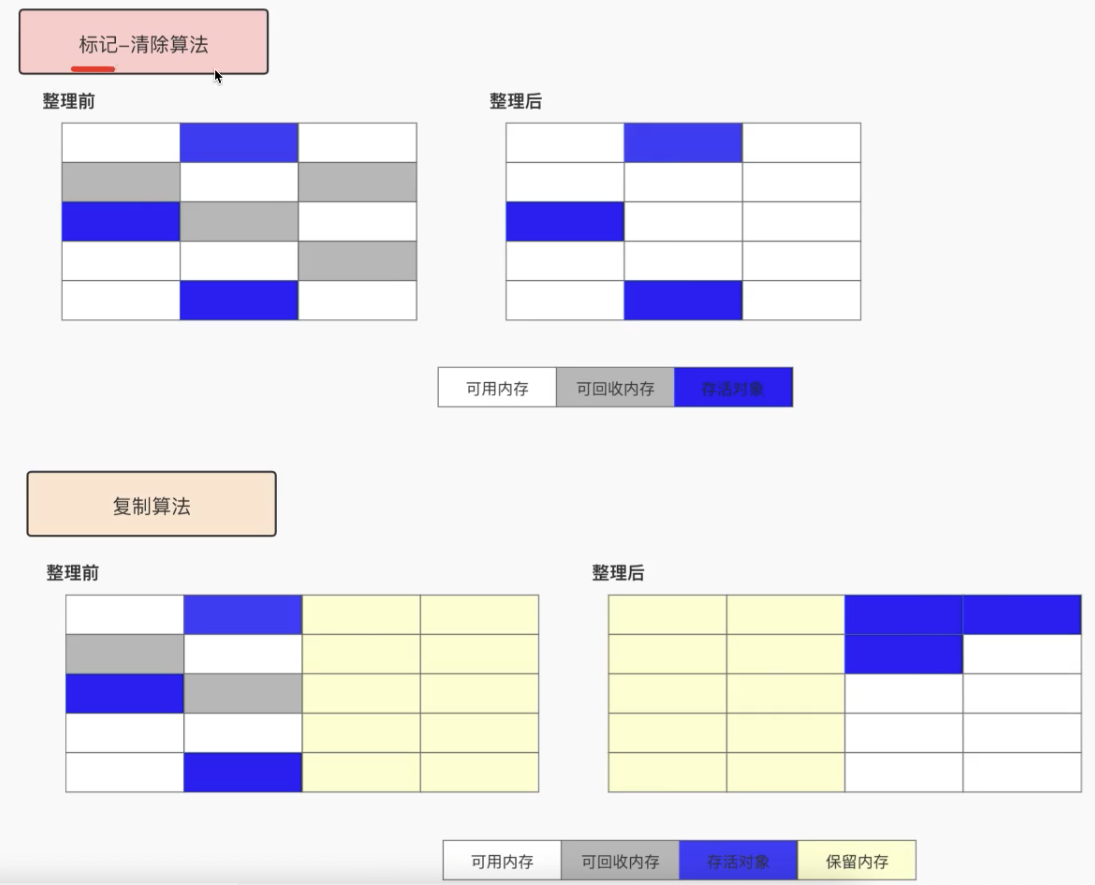 标记清除和复制算法
- 标记清除算法: 清楚标记好的垃圾对象(灰色),缺点是存在碎片空间
- 复制算法: 分为两个区域,将存活对象移至另一侧整理好,这一侧全部清理,以此类推
 标记整理和分代算法
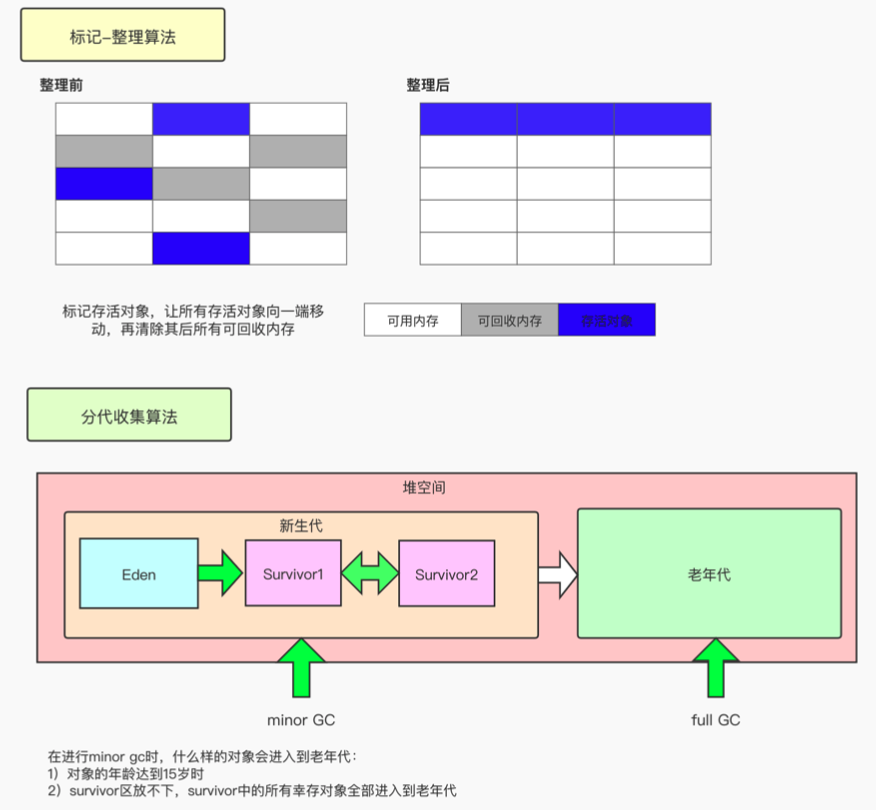
- 标记整理算法: 标记存活对象,让所有存活对象向一端移动,再清除其后所有可回收内存
- 分代收集算法: 在进行minor gc时,什么样的对象会进入到老年代:
- 1)对象的年龄达到15岁时
- 2) survivor区放不下,survivor中的所有幸存对象全部进入到老年代
2.分代回收算法
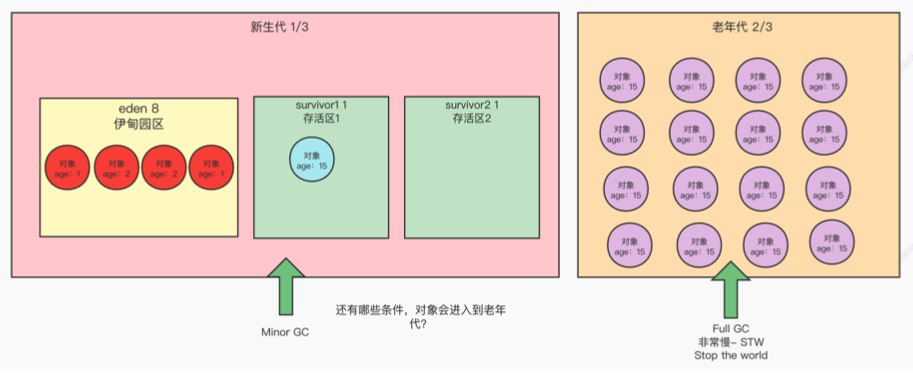
堆空间被分为: (1/3)表示占用空间大小
- 新生代(1/3) : 伊甸园(8/10)、存活1(1/10)、存活2(1/10)
- 老年代(2/3)
 分代回收算法
- 对象的创建在eden,年龄1,如果放不下则触发Minor gc,针对整个新生代做一次gc
- 对象经过一次minorgc 后存活的对象会被放入到survivor区,并且年龄+1
- 以此类推,创建 -> Minor gc -> 移动 -> 年龄+1
- survivor区执行的复制算法,当对象年龄到达15,进入到老年代。
- 如果老年代放满。就会触发Full GC(会造成STW stop the world,用户线程都必须等待FC执行完后再执行)
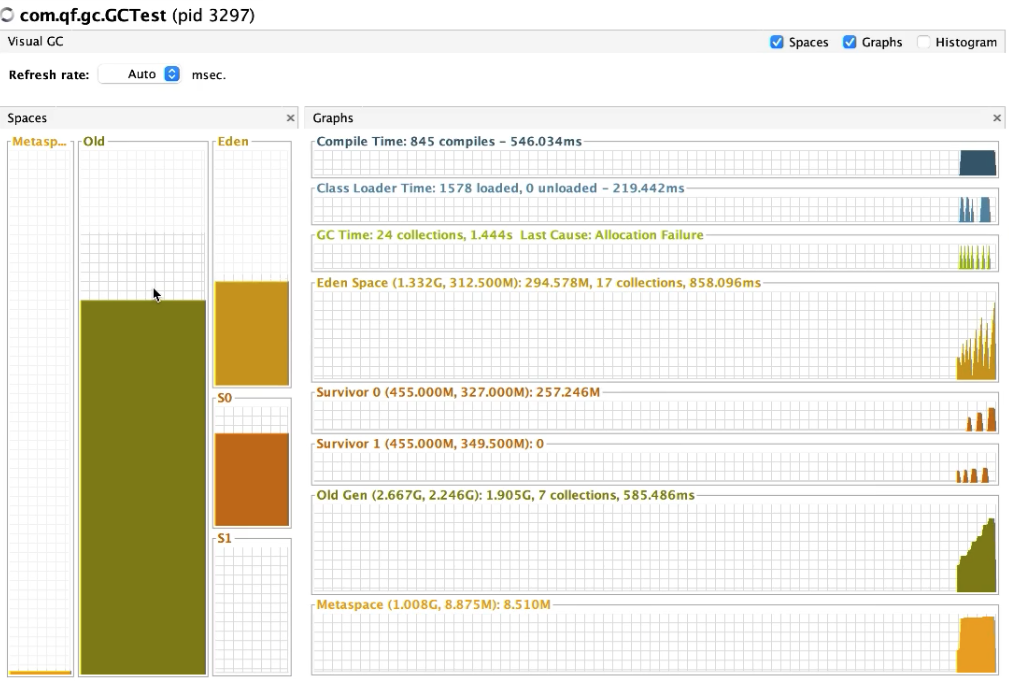
可以使用Java VisualVM查看整个java程序的JVM情况,打开程序后点击本地的pid,再点击右侧的VisualGC查看图像。
 Java VisualVM
若FC执行完依然没有空间,则会报OutOfMemoryError错误。
3.对象进入到老年代的条件(大对象、15岁、动态年龄(S空间大于50%)、老年代空间分配担保机制)
-
大对象直接进入到老年代:大对象可以通过参数设置大小,多大的对象被认为是大对象。-XX:PretenureSizeThreshold,可设置为1m。
-
当对象的年龄到达15岁时将进入到老年代,这个年龄可以通过这个参数设置:- XX:MaxTenuringThreshold,例如5岁,但是什么样的对象应该被设置成5岁就进入老年代?
- 根据对象动态年龄判断,如果s区中的对象总和超过了s区中的50%,那么下一次做复制的时候,把年龄大于等于这次最大年龄的对象都一次性全部放入到老年代。
- 例如S1区100mb,A对象3岁、B对象2岁、C对象1岁,ABC在Minor dc后,移动到S2区的大小仍然超过了100mb的50%,例如三者总和55mb。且因为移动了,所以A对象4岁,B对象3岁,C对象2岁,S2区大于等于3岁的对象都将移动进老年代。
- 老年代空间分配担保机制: 在minor gc时,检查老年代剩余可用空间是否大于年轻代里 现有的所有对象(包含垃圾)。如果大于等于,则做minor gc。如果小于,看下是否配 置了担保参数的配置:-XX: -HandlePromotionFailure ,如果配置了,那么判断老年代剩 余的空间是否小于历史每次minor gc 后进入老年代的对象的平均大小。如果是,则直接 full gc,减少一次minor gc。如果不是,执行minor gc。如果没有担保机制,直接full gc。
- 例如在Minor GC之前,新生代有4个对象要分配,老年代剩余空间只有2个,查看是否配置担保参数,无配置则直接Full GC。因为空间不够迟早要Full GC。
- 配置了则看历史,例如每次新生代有4个对象,在minor gc后,进入老年代的只有1个对象,说明老年代还放得下,则可执行Minor GC
- 总的来说要不就是可以节省一次minor gc要不就是节省时间直接full gc。
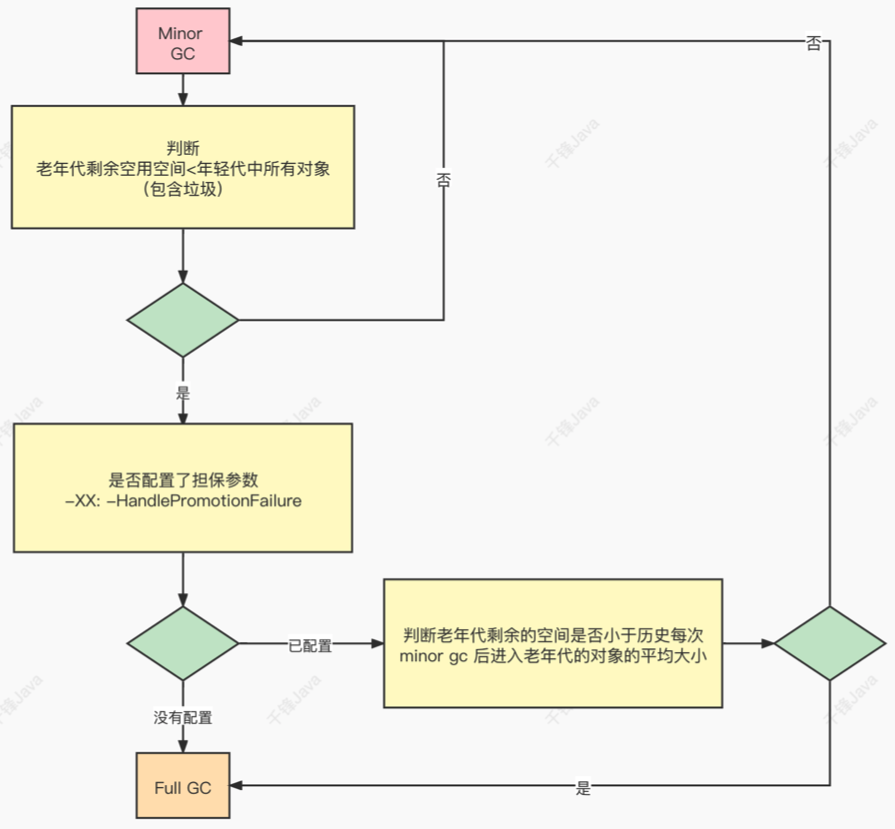 老年代空间分配担保机制,图片有点误区,不是minorgc之后,是minorgc之前
八、垃圾回收器
垃圾回收机制,我们已经知道什么样的对象会成为垃圾。对象回收经历了什么——垃圾回收 算法。那么谁来负责回收垃圾呢?
接下来就来讨论垃圾回收器。
1.Serial收集器(—XX:+UseSerialGC—XX:+UseSerialOldGC)(单线程GC全STW)
单线程执行垃圾收集,收集过程中会有较⻓的STW(stop the world),在GC时工作线程不能工作。虽然STW较⻓,但简单、直接。
新生代采用复制算法,老年代采用标记-整理算法。
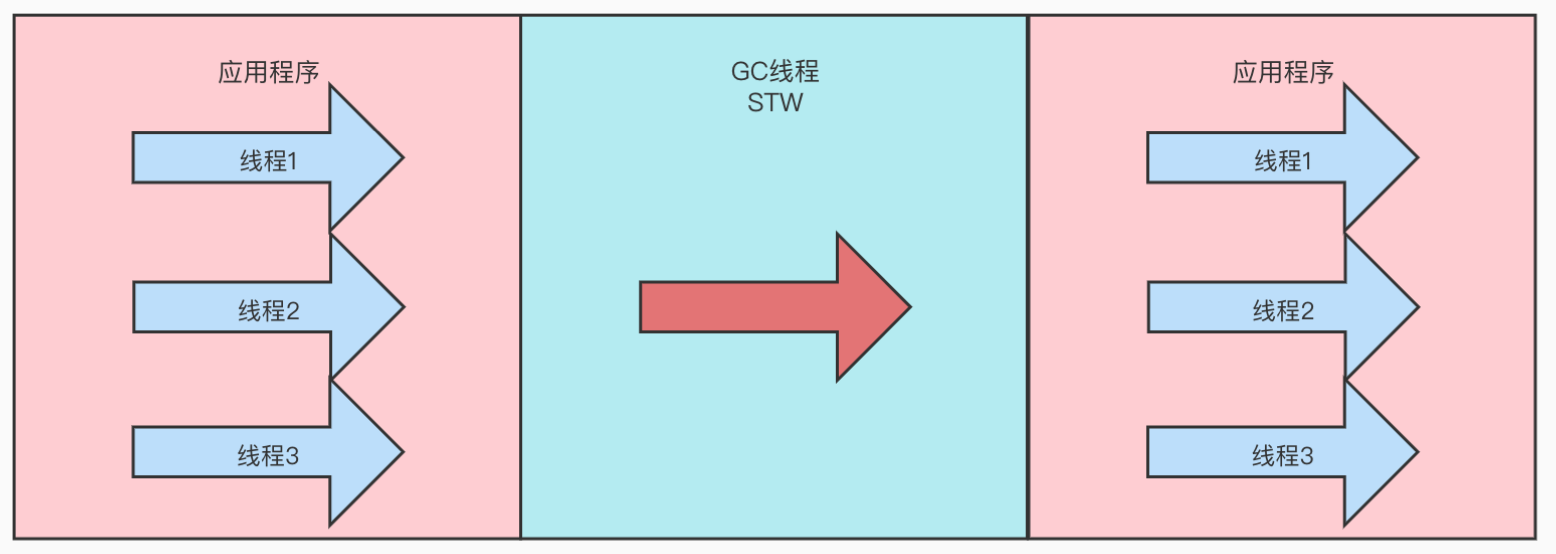 Serial收集器
2.Parallel收集器(-XX:+UseParallelGC.-XX:+UseParallelOldGC)(多线程GC全STW)
使用多线程进行GC,会充分利用cpu,但是依然会有stw,这是jdk8默认使用的新生代和老年 代的垃圾收集器。充分利用CPU资源,吞吐量高。
新生代采用复制算法,老年代采用标记-整理算法。
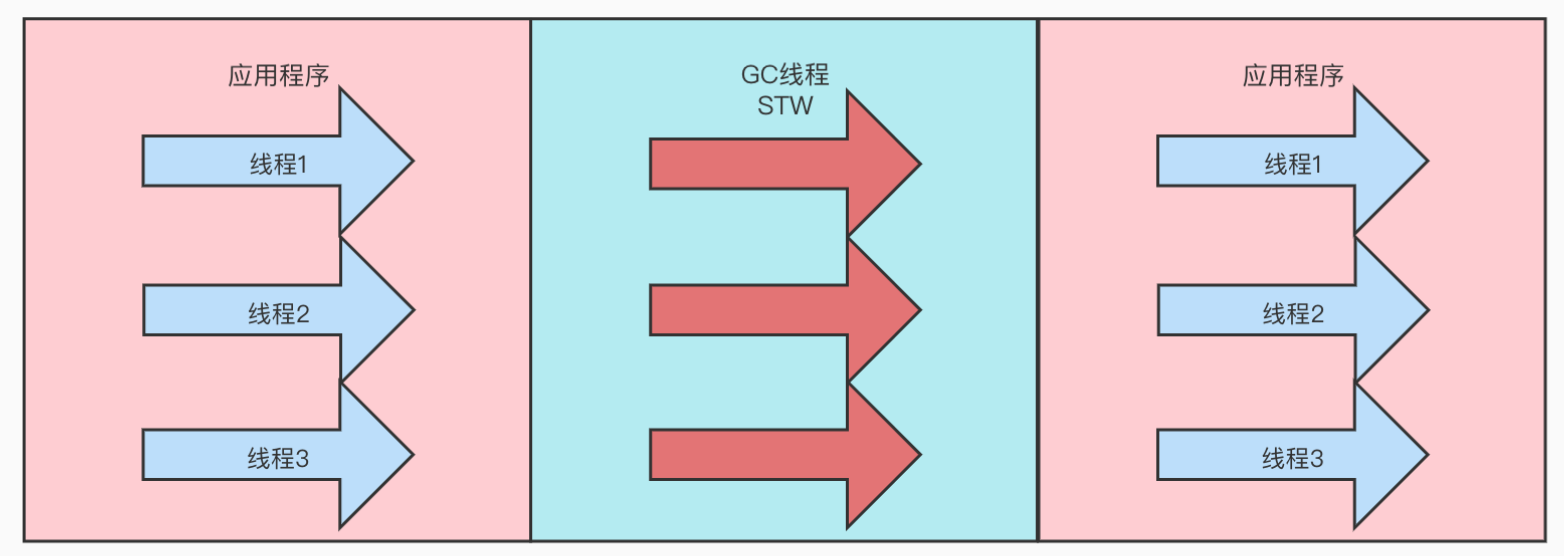 Parallel收集器
3.ParNew收集器(—XX:+UseParNewGC)(复制+标记整理,用于新生代,配合CMS)
工作原理和Parallel收集器一样,都是使用多线程进行GC,但是区别在于ParNew收集器可以和CMS收集器配合工作。主流的方案:
ParNew收集器负责收集新生代。CMS负责收集老年代。
Parallel收集器
4.CMS收集器(-XX:+UseConcMarkSweepGC)(用于老年代,配合ParNew)
目标:尽量减少stw的时间,提升用户的体验。真正做到gc线程和用户线程几乎同时工作。
CMS采用标记-清除算法。
- 初始标记: 暂停所有的其他线程(STW),并记录gc roots直接能引用的对象。
- 并发标记: 从GC Roots的直接关联对象开始遍历整个对象图的过程,这个过程耗时较⻓,但是不需要STW,可以与垃圾收集线程一起并发运行。这个过程中,用户线程和GC线程并发,可能会有导致已经标记过的对象状态发生改变。
- 重新标记(三色标记): 为了修正并发标记期间因为用户程序继续运行而导致标记产生变动的那一部分对象的标记记录,这个阶段的停顿时间一般会比初始标记阶段的时间稍⻓,远远比并发标记阶段时间短。主要用到三色标记里的算法做重新标记。
- 并发清理: 开启用户线程,同时GC线程开始对未标记的区域做清扫。这个阶段如果有新 增对象会被标记为黑色不做任何处理。
- 并发重置: 重置本次GC过程中的标记数据。
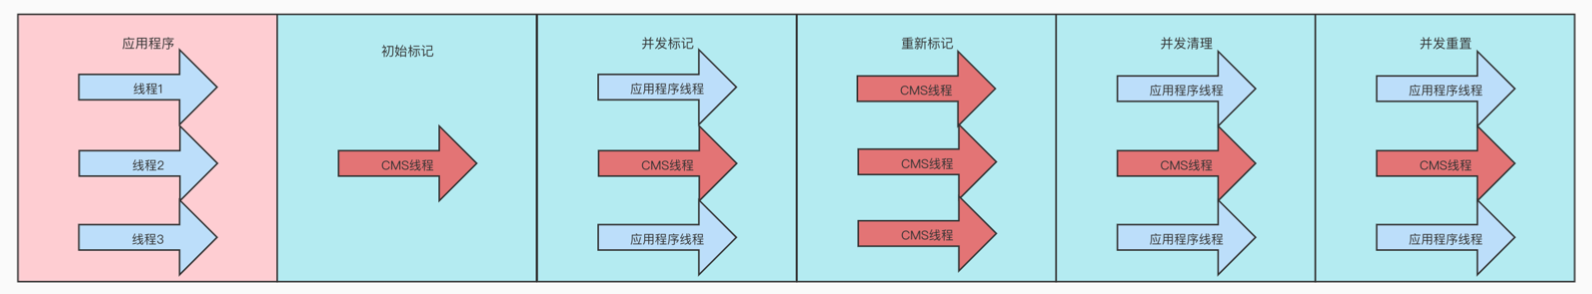 CMS收集器
整个流程比较耗时的是并发清理阶段,出现STW的时间只是做个标记(并发标记+重新标记),所以大幅度减少了STW的时间。
5.三色标记算法(黑色标记,灰色引用未标记,白色回收)
在并发标记阶段,对象的状态可能发生改变,GC在进行可达性分析算法分析对象时,用三色来标识对象的状态
- 黑色:这个对象及其所有引用都已被GC Roots遍历,黑色的对象不会被回收
- 灰色:这个对象被GC Roots遍历过但其部分的引用没有被GC Roots遍历。在重新标记时 重新遍历灰色对象。
- 白色:这个对象没有被GC Roots遍历过。在重新标记时该对象如果是白色的话,那么将 会被回收。
6.垃圾收集器组合方案(推荐ParNew+CMS)
不同的垃圾收集器可以组合使用,在使用时选择适合当前业务场景的组合。
| 年轻代 | 老年代 | 备注 |
|---|---|---|
| Serial | Serial Old | 简单、直接 |
| Serial | CMS | |
| ParNew | CMS | 推荐使用 |
| ParNew | Serial Old | |
| Parallel | Parallel Old | 吞吐量高、jdk8默认使用的组合 |
| Parallel | Serial Old |
九、JVM调优实战
1.JVM调优的核心参数
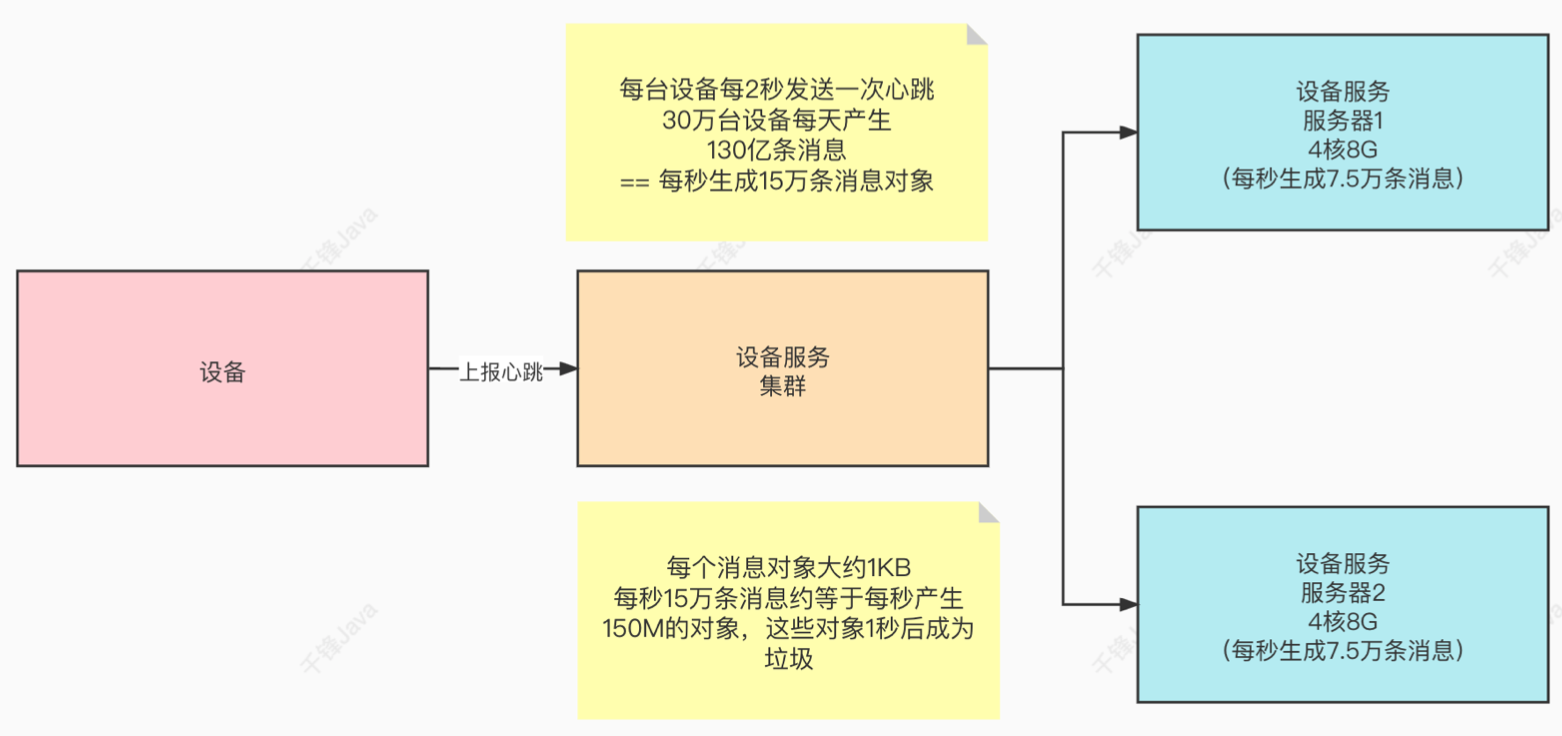 JVM调优的核心参数
-Xss:每个线程的栈大小。设置越小,说明一个线程栈里能分配的栈帧就越少,但是对JVM整 体来说能开启的线程数会更多。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
public class StackOverflowTest {
    static int count = 0;

    static void add() {
        count++;
        add();
    }

    public static void main(String[] args) {
        try {
            add();
        } catch (Throwable t) {
            t.printStackTrace();
            System.out.println(count);
        }
    }
}
1
2
3
4
运行结果:
java.lang.StackOverflowError
at com.jvm.StackOverflowTest.redo(StackOverflowTest.java:12)
......
-Xms: 设置堆的初始可用大小,默认物理内存的1/64
-Xmx: 设置堆的最大可用大小,默认物理内存的1/4
-Xmn: 新生代大小
-XX:NewRatio: 默认2表示新生代占年老代的1/2,占整个堆内存的1/3。假设整个堆有3个G,老年代有2个G,新生代有1个G。
-XX:SurvivorRatio: 默认8表示一个survivor区占用1/8的Eden内存,即1/10的新生代内存。
以下两个参数设置元空间大小建议值相同,且写死(8个的内存256M是比较合适的),防止在程序启动时因为需要元空间的空 间不够而频繁full gc。
-XX:MaxMetaspaceSize: 最大元空间大小。
-XX:MetaspaceSize: 元空间的初始化大小,默认是21M,达到该值后会触发Full GC,同时会按100% 进行动态调整,为了减少大数据量占满元空间,频繁触发Full GC,建议在初始化时设置为跟 MaxMetaspaceSize相同的值。
2.JVM调优实战
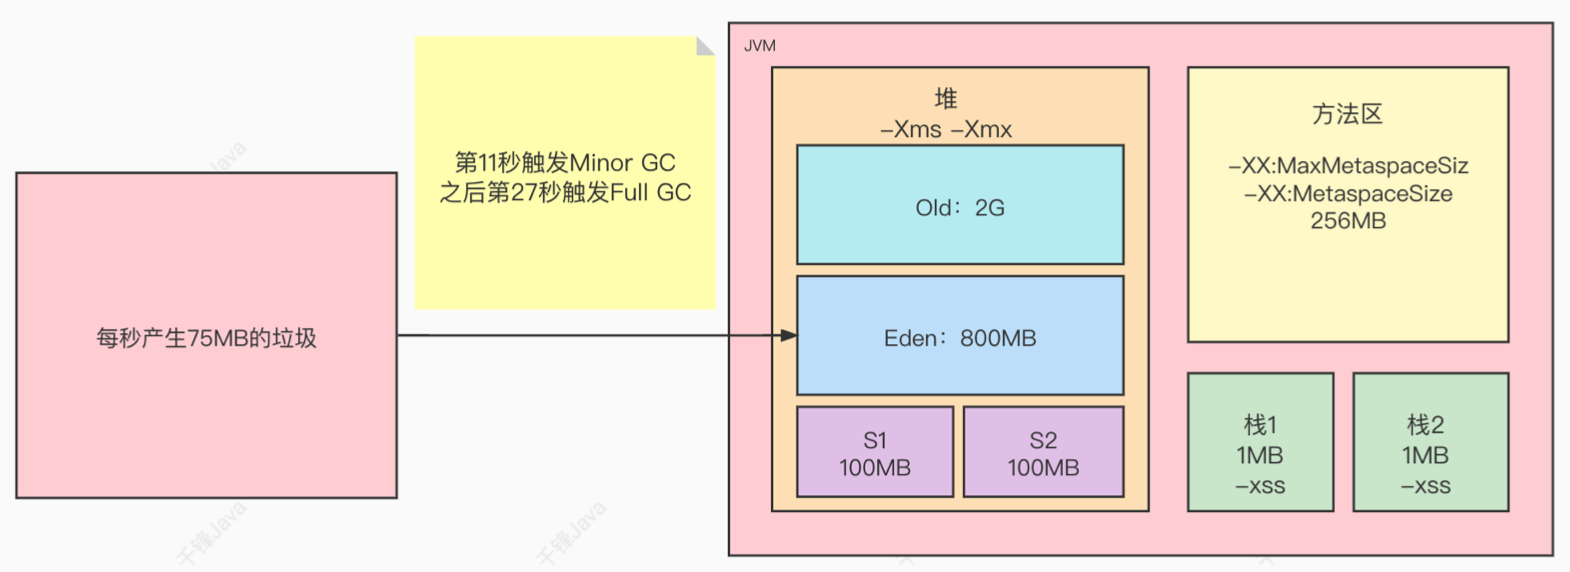
原有设置的JVM参数: 堆空间3G,线程栈1M,元空间256M,新生代的比例是8:1:1
1
‐Xms3072M ‐Xmx3072M ‐Xss1M ‐XX:MetaspaceSize=256M ‐XX:MaxMetaspaceSize=256M ‐XX:SurvivorRatio=8
 JVM调优实战
Eden会在大约第11秒的时候放满(800/75),触发Minor GC后会到S1区,但是由于75M大于S1的50%,触发了动态年龄判断,导致没多久就到了老年代,直到大概27个11秒后(2048/75),大约5分钟的时间,老年代就满了,触发Full GC。这样就不合理了,触发Full GC一定是几天或者几周做一次。所以显然是空间分配不合理。
调整JVM参数:
1
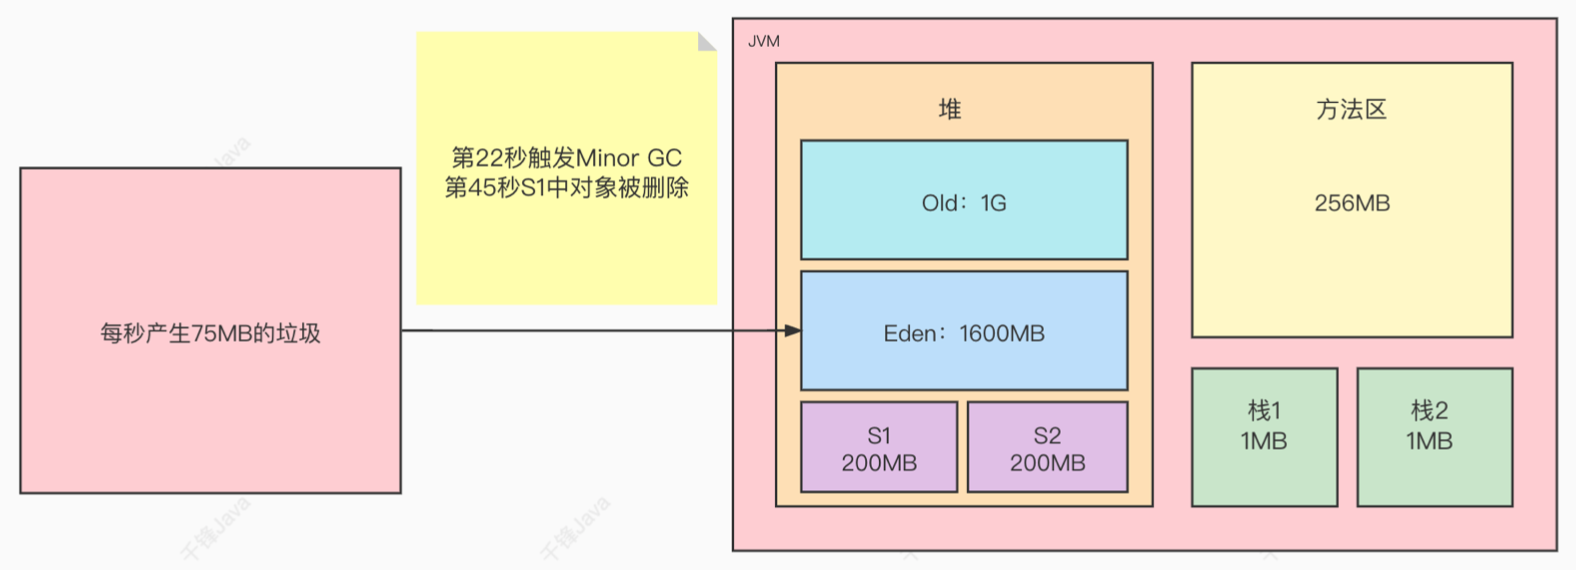
‐Xms3072M ‐Xmx3072M ‐Xmn2048M ‐Xss1M ‐XX:MetaspaceSize=256M ‐XX:MaxMetaspaceSize=256M ‐XX:SurvivorRatio=8
 调整JVM参数
重新调整过后,75M的垃圾放满Eden需要22秒(1600/75),触发Minor GC后75M到S1区并没有到S1区的50%,下一个22秒又会触发Minor GC,但是这22秒的时间,这些在S1区的75M垃圾就被清理掉了,这样就能一直保证75M垃圾不会进入老年代。
3.调优的关键点
- 设置元空间大小,最大值和初始化值相同。
- 根据业务场景计算出每秒产生多少的对象。这些对象间隔多⻓时间会成为垃圾(一般根据 接口响应时间来判断)
- 计算出堆中新生代中eden、survivor所需要的大小: 根据上一条每条产生的对象和多少时间成为垃圾来计算出,依据是尽量减少Full gc的次数。
4.结合垃圾收集器的调优策略
结合垃圾收集器: PraNew+CMS,对于CMS的垃圾收集器,还需要加上相关的配置:
- 对于一些年龄较大的bean,比如缓存对象、spring相关的容器对象,配置相关的对象,这些对象需要尽快的进入到老年代,也就是规定对象的年龄,因此需要配置:
-XX:MaxTenuringThreshold=5 - 大对象直接进入到老年代:
-XX:PretenureSizeThreshold=1M - CMS垃圾收集器会有并发模式失败的⻛险(转换为使用serialOld垃圾收集器),如何避免这种⻛险:将Full gc的触发点调低:
-XX:CMSInitiatingOccupancyFraction=85(默认是92%),相当于老年代使用率达到85%就触发Full gc,于是还剩15%的空间允许在cms进行gc的过程中产生新的对象。 - CMS垃圾收集器收集完后会产生碎片,碎片需要整理,但不是每次收集完就整理,设置做了3次Full GC之后整理一次碎片:
-XX:+UseCMSCompactAtFullCollection -XX:CMSFullGCsBeforeCompaction=3
PraNew+CMS的具体JVM参数配置:
1
2
3
4
java -Xms3072M -Xmx3072M -Xmn2048M -Xss1M -XX:MetaspaceSize=256M
-XX:MaxMetaspaceSize=256M -XX:SurvivorRatio=8 -XX:MaxTenuringThreshold=5
-XX:PretenureSizeThreshold=1M - XX:+UseParNewGC -XX:+UseConcMarkSweepGC -XX:CMSInitiatingOccupancyFraction=85
-XX:+UseCMSCompactAtFullCollection -XX:CMSFullGCsBeforeCompaction=3 -jar device-service.jar
总结
最开始我们讲到,JVM是如何工作的,由类加载系统、运行时数据区、执行引擎工作的,执行引擎很多都是用C++写的,所以没有详细讲,其次讲了类加载过程,其中也讲了双亲委派机制,原理就是loadClass,也就是查看是否加载过当前类,如果未加载过就找父加载器加载,父加载器也执行loadClass的代码,也同理。父类找不到就抛异常,再回到自己的类里也找不到再抛异常,如果找到就直接返回。还讲到了如何通过自定义类加载器去打破双亲委派机制,就是不要去父加载器找即可。
加载类进方法区之后,运行时数据区是怎么运行的,发生了什么变化,是我们接下来讲的,了解运行时数据区的几个部分是如何协调工作的,通过反编译的指令查看了。
再往下就是对象是如何创建的,首先要查看类是否加载,若未加载则需加载,若加载了则在堆空间中设置初值,设置对象头,在对象头内有些复杂的逻辑,比如说,对象头内的Mark Work标记。
然后这些对象有可能会成为垃圾,继续讲了JVM的垃圾回收机制,什么样的对象会成为垃圾,可达性GC Roots。知道哪些对象是垃圾之后,并不会直接回收,而会执行finalize,并且会逃逸分析,并且会使用标量替换来节省栈空间。
介绍垃圾回收算法,还有重点是进入老年代的三个条件。大对象、15岁、动态年龄(S空间大于50%)、老年代空间分配担保机制。了解完垃圾回收算法之后,介绍了垃圾回收器的种类,推荐使用ParNew(新生代)+CMS(老年代),同时引出了三色标记算法。
最后是如何进行JVM调优的实战。
实践
- 清晰的掌握类加载过程及双亲委派机制
- 掌握程序在运行时 JVM的运行时数据区中发生了怎样的变化
- 对象的创建的流程
- 对象成为垃圾的判断依据
- 垃圾回收算法有哪些
- JVM空间内存分配及垃圾回收器的常用参数配置